Seit der Einführung von Google Overviews (SGE) nimmt organische Traffic massiv ab.
Generative künstliche Intelligenz beantwortet komplexe Suchanfragen direkt. Der Nutzer erhält seine Antwort ohne jemals auf einen Link zu klicken.
Zero-Click-Suchen machen laut aktuellen Similarweb-Daten 68% aller Google-Suchen aus.
Was bedeutet vom Keyword zur Entität?
Vom Keyword zur Entität bedeutet der Wechsel von der Optimierung auf reine Suchbegriffe hin zur Optimierung auf semantische Informationseinheiten (Entitäten), die Suchmaschinen als eindeutige Objekte mit spezifischen Attributen und Beziehungen verstehen.
Was ist eine Entität?
Eine Entität ist ein eindeutig identifizierbares Objekt, Lebewesen, Ort oder abstraktes Konzept (Entität im engl. Entity), als Einheit in einer Datenstruktur (hier Google NG) existiert.
Die Enitäten snd als konkrete Dinge „Things“ mit spezifischen Attributen und messbaren Beziehungen zu anderen Entitäten in einem semantischen Netzwerk (Knowledge Graph).
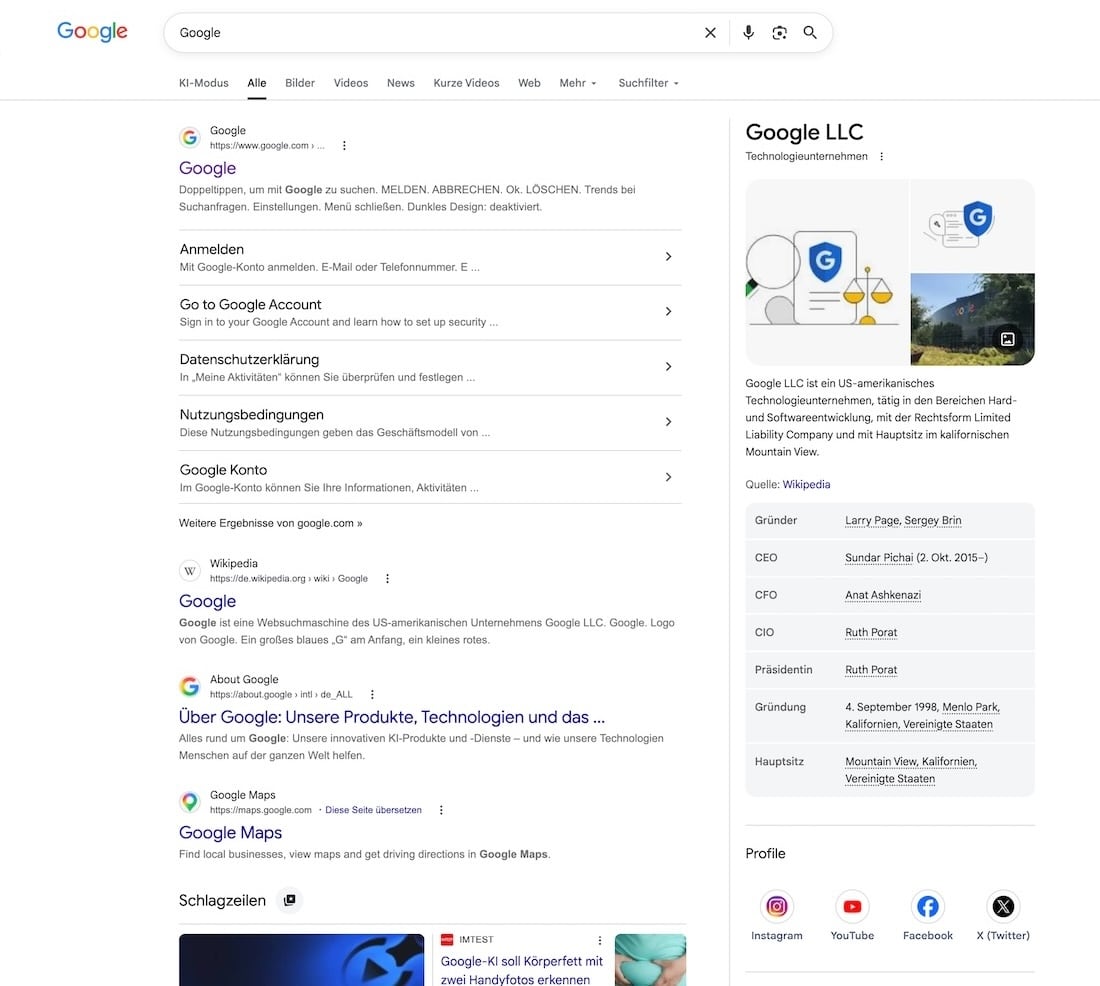
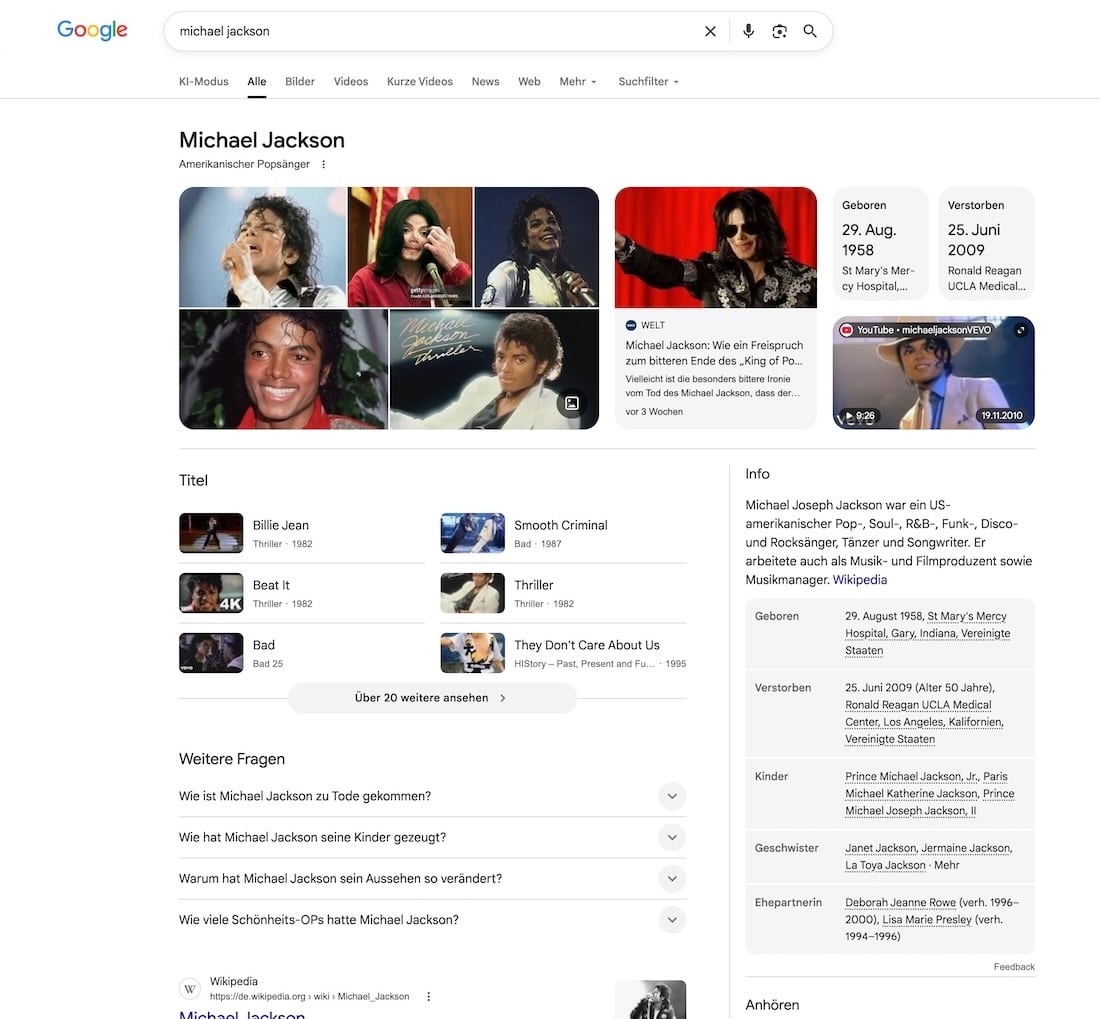
Wie optimmert man auf Entitäten – welche passen überhaupt?
Entity-SEO funktioniert durch die Strukturierung von Daten, den Aufbau von thematischen Inhalts-Netzwerken (Topic Clusters) und die eindeutige Verknüpfung von Begriffen im Knowledge Graph von über Schema.org-Auszeichnungen. Semantische Relevanz steigern, Topic Clustering aufbauen, Strukturierte Daten implementieren, Interne Verlinkung zeigt die Relation.
Wie bewertet Google die Relevanz mittels Entity Metrics?
Google bewertet die Relevanz von Webdokumenten über Entity Metrics, indem der Algorithmus Kookkurrenzen innerhalb definierter Phrasen-Cluster. Dieses System misst die mathematische Distanz zwischen extrahierten Begriffen und etablierten Knotenpunkten im Knowledge Graph.
Site Quality Score (Domain-Qualitätswert)
Google führte den Site Quality Score ein, um die algorithmische Abwertung von skaliertem Webspam über das kollektive Nutzerverhalten einer gesamten Domain zu steuern. Berechnet ein Verhältnis von:
direkter Marken-Nachfrage zu allgemeinen Klicks:
- S : Anzahl der eindeutigen navigations- oder markenbezogenen Suchanfragen
- U : Anzahl aller Nutzersuchen, die zu einer Auswahl („User Selection“) auf dieser Domain führen.
- T : Schwellenwert (Threshold), um Rauschen bei kleinen Websites auszufiltern.
- B : Basiswert (Base Value) zur Glättung.
„A site quality score for a particular site can be determined by computing a ratio of a numerator that represents user interest in the site as reflected in user queries directed to the site and a denominator that represents user interest in the resources found in the site…“ Site Quality Score, US9031929B1.
Der Score trennt echte Marktteilnehmer von künstlich optimierten Nischen-Websites.
Implicit User Feedback
Google nutzt Implicit User Feedback, um die statische Websiteneinstufung durch die Echtzeit-Zufriedenheit der Nutzer dynamisch zu korrigieren. Die technologische Grundlage hierfür beschreibt das Google-Patent US8661029B1 (Modifying search results based on implicit user feedback), welches die algorithmische Gewichtung von Klick- und Verweildaten regelt.
Die NavBoost-Infrastruktur dient als zentraler Beleg und speichert Klickprotokolle über einen Zeitraum von 13 Monaten. Gemessen wird die korrigierte LCPC-Fraktion (Last Click In Current session) als finaler Klick ohne unmittelbaren Bounce.
Die Unberechenbarkeit der Google-Logik
Suchmaschinenoptimierung im Zeitalter von „Things, not Strings“ zwingt Webseitenbetreiber in einen permanenten Kampf gegen eine mathematische Black Box, deren Definition von „Logik“ rein statistischen Wahrscheinlichkeiten folgt.
Die algorithmische Entmenschlichung der Relevanz — Claim
Google bewertet Inhalte nicht mehr nach menschlich-rationaler Logik, sondern über hochdimensionale Vektordistanzen.
- Beweis (Evidence): Tiefe neuronale Netze und Transformer-Modelle zerlegen Dokumente in abstrakte Vektoren mit Hunderten von Dimensionen [Q60748154].
- Kontext (Context): Was für einen Experten einen logischen, stilistisch hochwertigen Text darstellt, stuft das mathematische Modell als „Rauschen“ ein, wenn die statistisch gelernten Wort-Abstände (Kookkurrenzen) vom Durchschnitt des Internets abweichen.
Was es für Webseitenbetreiber schwerer macht?
Die totale strategische Unberechenbarkeit
Betreiber können Rankings nicht mehr durch lineares Nachdenken garantieren. Verändern Core-Updates die mathematischen Gewichte im Vektorraum, stürzen fachlich perfekte Seiten ohne inhaltliche Änderungen ab.
Tyrannei der Maschinenlesbarkeit
Der Algorithmus zwingt Unternehmen zur Produktion von „High-Contrast“-Content. Inhalte müssen in radikal komprimierte Fakten-Strukturen gepresst werden, da Nuancen und kreative Sprachstrukturen durch die Vektor-Quantisierung (Kompression auf 3, 4 oder 5 Bit) zu mathematischem Datenmüll herabgestuft werden.
Verlust der inhaltlichen Souveränität
Man optimiert nicht mehr für den Verstand des Lesers, sondern für fehlerfreies Information Retrieval des Parsers. Wer die harten, erwarteten Phrasen-Cluster des Modells nicht exakt bedient, erleidet trotz maximaler Fachexpertise den totalen digitalen Sichtbarkeitsverlust.
Hier erfolgt der Wechsel von der reinen Zeichenkettenanalyse („Strings“) zum Verständnis von Konzepten, Fakten und mathematisch modellierten Worträumen („Things“).
Phrase-Based Indexing & Entity Metrics
Google führte Phrase-Based Indexing in an Information Retrieval System: US7536408B2 ein um Keyword-Stuffing durch leicht manipulierbar Keywords („Strings“) und phrasenfreie Inhalte ignoriert, bveide erfüllen die statistisch erwartete Phrasen-Kopplungen (Prediction Measures) nicht.
Die Zuordnung unstrukturierter Texte zu klaren Subjekt-Prädikat-Objekt-Tripeln (Fakten) mit eindeutigen Objekt-IDs. Google versteht Texte als verknüpfte Netzwerke aus eindeutigen Objekten, Fakten und Konzepten im Knowledge Graph („Things“).
Der Algorithmus erkennt anhand fehlender Co-occurrences minderwertige Inhalte.
Google verknüpft Phrasen mit Entitäten im Knowledge Graph, ist eine Marke oder Autor keine verifizierte Entität mit Digitaler Reputation (Contribution/Prize Metric) verliert der gesamte Content Trust/Vertrauen. Es gilt Inhalte ohne Entitäten sind tot.
Vektorraum & Natural Language Processing (BERT & Transformers)
Computing Numeric Representations of Words in a High-Dimensional Space: US9037464B1 / US10241997B1 Mathematische Dekodierung menschlicher Sprache — Claim
Der technologische Quantensprung: Word2Vec & Kontextualisierte Embeddings (BERT). Google führte Deep-Learning-Modelle wie BERT ein, um Zeichenketten (Strings) durch das mathematische Verständnis von Kontext und Absichten (Things) im Vektorraum zu ersetzen.
- Self-Attention-Mechanismen: Ein neuronaler Gewichtungsprozess, bei dem jedes Wort in einer Sequenz im exakten Kontext aller umgebenden (linken und rechten) Wörter bewertet wird.
- Vektorkomponenten:
- Token Embeddings: Basierend auf dem Vokabular (z. B. WordPiece).
- Segment Embeddings: Kennzeichnung der Satzzugehörigkeit bei Satzpaaren.
- Position Embeddings: Mathematische Kodierung der exakten Wortreihenfolge mittels Sinus- und Kosinus-Frequenzen.
[CLS]-Token-Vektor: Der finale aggregierte Sequenzvektor am Ausgang tiefer bidirektionaler Transformer-Schichten (z. B. BERT), welcher die semantische Essenz der gesamten Eingabe repräsentiert.
Information Gain Score (IGS)
Radikale Eliminierung von Content-Duplikation — Claim
In Contextual Estimation of Link Information Gain beschreibt Goolge die mathematische Berechnung (relative Entropie), mit der Google ermittelt, ob ein neues Dokument einem Nutzer echten, ungelesenen Mehrwert liefert. Ein massiver Filter gegen Content-Redundanz und KI-Spam. Google bewertet, ob ein Dokument dem Nutzer tatsächlich neue Fakten oder Entitäten liefert, die in zuvor konsumierten Dokumenten noch nicht enthalten waren.
- Set \(d_1\) (Viewed Documents): Dokumente, die der Nutzer in seiner aktuellen Sitzung bereits gesehen oder aufgerufen hat.
- Set \(d_2\) (Unviewed Documents): Neue, noch ungesehene Dokumente, die als Suchergebnisse infrage kommen.
Was es für Webseitenbetreiber schwerer macht?
Der Tod von Standard-Content: Maschinell generierte Texte, die nur bestehendes Internetwissen umschreiben, besitzen kein Fakten
Zwang zum exklusiven Informations-Mehrwert: Ein Betreiber muss nachweisbar neue Daten, Studien, Grafiken oder proprietäre Erkenntnisse einbringen
Unsichtbarkeit in generativen Antworten: Da Stateful Chats den Contextual User State (Nutzerzustand 871) im Arbeitsspeicher halten und Synthetic Queries
Query Fan-Out
Query Fan-Out bezeichnet den Prozess, bei dem eine einzelne Query in parallele Teilabfragen zerlegt und an ein Klassifikations-Framework im Algorithmus sendet.
Google nutzt den Query Fan Out zur Multi-Intent Coverage, anstelle nur einen Suchintent anzunehmen, erkennt die Anfrage verschiedene implizite Bedürfnisse die der Nutzer nicht explizit gestellt hat.
- Equivalent Query:
- Follow-up Query
- Generalization Query
- Specification Query
- Canonicalization Query
- Language Translation Query
- Entailment Query:
- Clarification Query
Die vollständige Analyse Google-Patent: Search with Stateful Chat und den Suchintentions-Typen (Intent-Types).
Zwang zu Multi-Intensionalen Inhalten-Architektur
Betreiber müssen Inhalte so strukturieren, dass sie im Vektorraum sowohl die mathematische Theorie als auch den praktischen Proof of Work (Case Studies) abbilden.
Was passiert wenn Google Antworten selbst synthetisiert?
Das Google-Patent AI-generated content page tailored to a specific user beschreibt beschreibt ein System zur automatisierten Inhaltserzeugung direkt auf der Suchergebnisseite. Der Prozess startet beim Query Fan-Out, dieser zerlegt eine eingehende Suchanfrage in parallele, semantische Subqueries. und berechnet einen Landing Page Score. Erfüllt eine Webseite diese komplexen Anforderungen unzureichend, sinkt ihr Landing Page Score unter den definierten Schwellenwert
Google blockiert das Weiterleiten des Nutzers und generiert in Echtzeit eine KI-maßgeschneiderte Landingpage aus den strukturierten Indexdaten. Diese Seite enthält KI-generierte Produkt-Feeds, Call-to-Action-Buttons und integrierte KI-Chatbots.
Eine umfassende Analyse AI-Tailored Content Pages.
📍 Warum modernstes Information Retrieval so hart ist
Der Wechsel zum neuronalen Information Retrieval (Claim)
Google nutzt hochentwickelte mathematische Abruf-Modelle, um die semantische Distanz zwischen einer Suchanfrage und den indexierten Dokumenten im Vektorraum exakt zu berechnen.
- Beweis (Evidence):
Die Integration von neuronalen Netzen wie Twine und ScaNN (Scalable Nearest Neighbors) ermöglicht es dem System, Milliarden von Vektoren in Millisekunden auf Ähnlichkeit zu prüfen. - Kontext (Context):
Das System sucht nicht mehr nach passenden Wörtern, sondern gleicht mathematische Punktwolken von Texten mit dem Intent des Nutzers ab, um ungenaue oder künstlich aufgeblasene Inhalte sofort aus dem Such-Ergebnis zu filtern.
Was es für Webseitenbetreiber schwerer macht?
- Keine Verstecke für dünnen Content:
Wenn der Text keine echten, semantisch dichten Fakten-Vektoren liefert, fällt er beim Nearest-Neighbor-Abgleich gnadenlos durch. - Der Zwang zur logischen Struktur:
Wenn du kreuz und quer schreibst, verwässert das dein Vektorprofil. Das Dokument drifted ab und wird unauffindbar.
Patentverzeichnis und behördliche Primärquellen
Dandekar, N., Ravi, S. & Shah, P. (2023). Generating query variants using a trained generative model. United States Patent and Trademark Office. Patentnummer: US 11,663,201 B2. Anmelder: Google LLC. (Grundlage für Query Variant Generation und Query Fan-out).
Garg, S., He, T., Kan, K., & Rosales, R. (2024). Search with stateful chat. United States Patent and Trademark Office. Patentanmeldungsnummer: US 2024/0289407 A1. Anmelder: Google LLC. (Regelt die Speicherung des Contextual User State im Google AI Mode).
Lazovic, B., & Squires, J. (2026). AI-generated content page tailored to a specific user. United States Patent and Trademark Office. Patentnummer: US 12,536,233 B1. Anmelder: Google LLC. (Beschreibt das Erzeugen KI-generierter Landingpages bei unzureichendem Landing Page Score).
Pichai, S. (2014). Modifying search results based on implicit user feedback. United States Patent and Trademark Office. Patentnummer: US 8,661,029 B1. Anmelder: Google LLC. (Die technologische Patent-Basis für das NavBoost-Infrastruktur-Protokoll und die LCPC-Gewichtung).